Krafla
GPU 없이 CPU만으로 INT8/INT4 LLM을 돌리는 C11 추론 런타임입니다. SSE2·ARMv7 NEON부터 AVX-512 VNNI·SVE까지 지원합니다.
Krafla는 INT8·INT4로 양자화한 Llama 계열 언어 모델을 CPU에서 실행하는 C11 추론 런타임입니다. 외부 라이브러리가 필요 없고, x86-64는 SSE2부터 AVX-512 VNNI까지, ARM은 ARMv7 NEON부터 i8mm·SVE까지 지원합니다. 빌드할 때 명령어 집합(ISA)을 고르면 연산마다 그 ISA용 커널이 컴파일 때 정해지므로, 실행 중에 커널을 고르는 과정(런타임 디스패치)이 없습니다.
- 디코딩 속도: 같은 모델과 형식으로 측정한 모든 ISA에서 llama.cpp와 같거나 더 빠릅니다. AVX-512 VNNI 1.2–1.5배, AVX2 1.0–2.3배, SSE2·SSE4.1 2.1–10배, AArch64 1.04–1.7배입니다 (비교 자료, 영어).
- 구형·저전력 CPU: AVX가 없는 x86-64 CPU(Core 2, Athlon 64)와 32비트 ARMv7 보드에서도 돌아가며, GPU나 외부 라이브러리가 필요 없습니다. ISA마다 정적 바이너리가 있습니다.
- 낮은 Q4 퍼플렉서티: 블록마다 스케일을 맞춰 Qwen2.5 0.5B의 Q4_0 퍼플렉서티가 15.1로, llama.cpp Q4_0의 15.8–15.9보다 낮습니다. Q8은 F32 기준과 일치합니다.
- 결정적 출력: 스레드 수와 프롬프트 배치 크기를 바꿔도 출력이 비트 단위까지 같습니다.
- 모델: Llama 2/3, Mistral, Qwen2.5, Qwen3, Qwen3.5/3.6, SmolLM2, SmolLM3, Gemma 2, Gemma 3의 Hugging Face safetensors 파일을 토크나이저·대화 템플릿과 함께 변환해 씁니다.
llama.cpp 대비 디코딩 속도
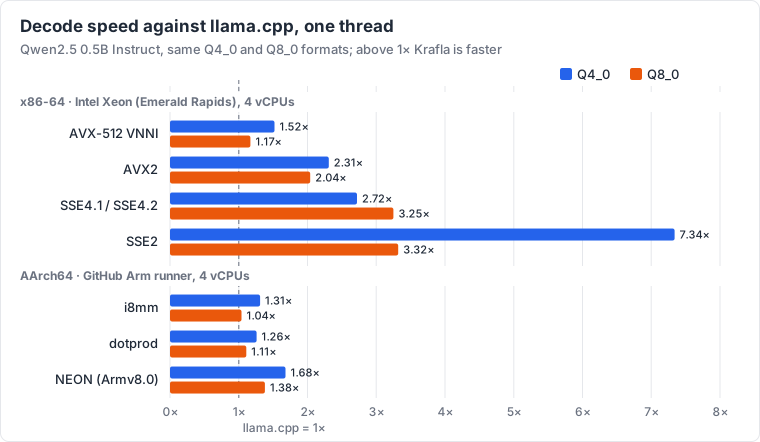
그래프는 Xeon 테스트 머신에서 1스레드로 잰 결과이며, 두 런타임 모두 Qwen2.5 0.5B Instruct를 같은 Q4_0·Q8_0 형식으로 실행했습니다. 위 목록의 배율 범위에는 GitHub 러너에서 잰 결과도 들어 있어서 SSE2는 최대 10배까지 나옵니다. 프롬프트 처리(prefill) 속도, 4스레드 결과, 퍼플렉서티는 비교 자료에 있습니다.
지원 CPU
빌드 하나는 ISA 하나를 대상으로 합니다. 릴리스 압축 파일의 ml_run은 CPU가 지원하는 가장 빠른 빌드를 골라 실행합니다. ISA가 맞지 않는 CPU에서 빌드를 실행하면 비정상 종료하지 않고, 빠진 기능을 알린 뒤 종료 코드 3으로 끝납니다.
| 빌드 | 최소 CPU |
|---|---|
sse2 | 모든 x86-64 (Athlon 64, Core 2) |
sse41 | Penryn, Nehalem |
avx2 | Haswell, Zen |
avxvnni | Alder Lake, Zen 5 |
avx512vnni | Cascade Lake, Ice Lake, Zen 4 |
neon | NEON이 있는 ARMv7, 모든 AArch64 (라즈베리 파이 2–4) |
neon_dotprod | Cortex-A55/A76 (라즈베리 파이 5), Apple M1 |
neon_i8mm | Cortex-A710, Neoverse N2/V1, Apple M2 |
sve | Neoverse V1/N2, Graviton 3 |
Linux용 릴리스는 x86-64, AArch64, ARMv7을, Windows용은 x86-64를 지원합니다. 라즈베리 파이용 빌드는 ISA만 보고 고른 것이며, 실제 보드에서는 아직 측정하지 않았습니다.
빠른 시작
릴리스와 Hugging Face의 Krafla 컬렉션에 있는 변환된 모델만 있으면 Python 없이 바로 실행할 수 있습니다. 압축을 푼 릴리스 폴더에서 다음 명령을 실행합니다.
# in the unpacked release
curl -LO https://huggingface.co/jonpark0/Qwen2.5-0.5B-Instruct-krafla/resolve/main/Qwen2.5-0.5B-Instruct-Q4_0.mlb
curl -LO https://huggingface.co/jonpark0/Qwen2.5-0.5B-Instruct-krafla/resolve/main/tokenizer.mlt
./ml_run Qwen2.5-0.5B-Instruct-Q4_0.mlb -z tokenizer.mlt --chat qwen -t 4
변환된 모델은 SmolLM2 135M·360M, Qwen2.5 0.5B·1.5B, Qwen3 0.6B, TinyLlama 1.1B입니다. 모델마다 Q4_0·Q8_0 파일이 있고, SmolLM2를 뺀 나머지는 혼합 정밀도 파일도 있습니다. 그 밖의 모델은 소스에서 빌드한 뒤 Hugging Face safetensors를 변환해 씁니다. ISA에는 avx2 대신 sse2, neon, neon_dotprod, sve 등을 지정할 수 있습니다.
make ISA=avx2                                    # or sse2, neon, neon_dotprod, sve, ...
python3 tools/convert.py hf ./Llama-3.2-1B-Instruct llama.mlb --wtype q4 --q8 v,o,down
python3 tools/convert_tokenizer.py ./Llama-3.2-1B-Instruct/tokenizer.json llama.mlt
build/avx2/ml_run llama.mlb -z llama.mlt --chat llama3 -t 4
자주 묻는 질문
AVX가 없는 CPU에서도 LLM을 돌릴 수 있나요?
네. sse2 빌드는 모든 x86-64 CPU에서, sse41 빌드는 Penryn·Nehalem 이후 CPU에서 돌아가며, 둘 다 직접 작성한 int8 SIMD 커널을 씁니다. 비교 머신에서 SSE2 빌드는 Qwen2.5 0.5B Q4_0을 1코어로 초당 25.7토큰, 4코어로 77.3토큰 생성했습니다. 최신 Xeon에서 SSE2 코드를 돌린 결과라 실제 구형 CPU에서는 더 느립니다.
llama.cpp와 비교하면 어떤가요?
디코딩은 측정한 모든 ISA에서 Krafla가 llama.cpp와 같거나 더 빠릅니다. 대신 llama.cpp는 GPU 백엔드, K-quant 형식, 더 많은 아키텍처(MoE, 이미지 입력)를 지원합니다. Krafla는 CPU에서 Q8_0·Q4_0 추론만 다룹니다.
OpenAI 클라이언트 라이브러리로 쓸 수 있나요?
네. ml_server가 모델을 OpenAI API(/v1/chat/completions, /v1/completions, /v1/models, 스트리밍 포함)로 제공합니다. openai Python·JavaScript 라이브러리나 base URL을 받는 도구에서 그대로 쓸 수 있습니다.
./ml_server Qwen2.5-0.5B-Instruct-Q4_0.mlb -z tokenizer.mlt --chat qwen -t 4
# base URL: http://127.0.0.1:8080/v1
요청은 한 번에 하나씩 처리하고, 요청 사이에 KV 캐시를 유지합니다. 그래서 대화의 다음 차례는 새로 추가된 토큰만 계산합니다.
메모리는 얼마나 필요한가요?
.mlb 파일 크기에 KV 캐시를 더한 만큼입니다. Q4 기준으로 Qwen2.5 0.5B는 265 MiB, Llama 3.2 1B는 663 MiB입니다. KV 캐시 크기는 --ctx로 정하는 문맥 길이에 비례합니다(기본 4096, 모델의 max_seq가 더 작으면 그 값). --kv f16은 KV 캐시를 절반으로, --kv q8은 약 3.8분의 1로 줄입니다.
이름은 무슨 뜻인가요?
크라플라(Krafla)는 아이슬란드 북부에 있는 화산 칼데라로, 지열 발전소가 있는 곳입니다. 이미 있는 열로 전기를 만들듯, 지금 가진 CPU로 LLM을 돌린다는 뜻도 담았습니다. 동시에 Kernels Retargeted Across Families of Legacy Architectures(여러 계열의 구형 아키텍처에 맞춰 다시 짠 커널)의 약자이기도 합니다. 0.5.0까지는 isa-lm이라는 이름이었습니다.
결과가 매번 같나요?
네. 스레드 수와 프롬프트 배치 크기를 바꿔도 출력값이 비트 단위로 같고, 탐욕적 디코딩(-T 0, 기본값)은 매번 같은 문장을 냅니다.
문서
아래 문서는 영어로만 되어 있습니다.
- FAQ: AVX 없는 CPU, 라즈베리 파이, llama.cpp 비교, 모델, 메모리
- 사용자 가이드: 빌드, 크로스 빌드, 모델 변환, 실행 옵션
- 서버: OpenAI 호환 API, 요청 필드, 보안
- llama.cpp와의 비교: ISA별 속도와 퍼플렉서티
- 아키텍처: 컴파일 시점 커널 결합, CPU 검사, 가중치 재배치, 스레드
- 변경 이력
소스 코드: https://github.com/JonPark0/krafla · 라이선스: MIT